
你知道吗?你其实能让 AI 更愿意推荐你
被 AI 引用,还是只是被提到?这道差距决定了 AI 会不会推荐你
很多品牌看到自己的名字出现在 ChatGPT 的回答里,就觉得赢了。这种心情能理解——感觉总算"被看见"了。但模型凭记忆说出你的名字,和它把你的实时页面当作引用(Citation)来源列出来,完全是两回事。而这两者之间的差距,比看上去要大得多。
有一次测试让我们印象很深。在一组高购买意图的对比类问题上,主流 AI 大多数时候都会提及(Mention)并推荐我们的客户——一家 B2B SaaS 品牌。这里说的"提及率",指的是在同一批 prompt、对每个模型反复提问后,回答里点名或推荐了该品牌的比例:Claude 大约 70%,ChatGPT 大约 65%。品牌显然已经"住进"了模型脑子里。但当我们去看回答下面的"参考来源"列表时——该品牌在被引用最多的前 20 个域名里,只排到第 19 名。说白了:在这些 AI 回答真正拉取的所有来源网站里,我们几乎是最后才被想起的那个,而且大多数时候根本没被引用。一个直接竞争对手被引用的次数,是我们的十倍左右。嘴上认你,来源单上不认你。我们之前给它起过名字——被提及但没被引用的鸿沟;这篇要讲的是,补上这道差距到底值多少。
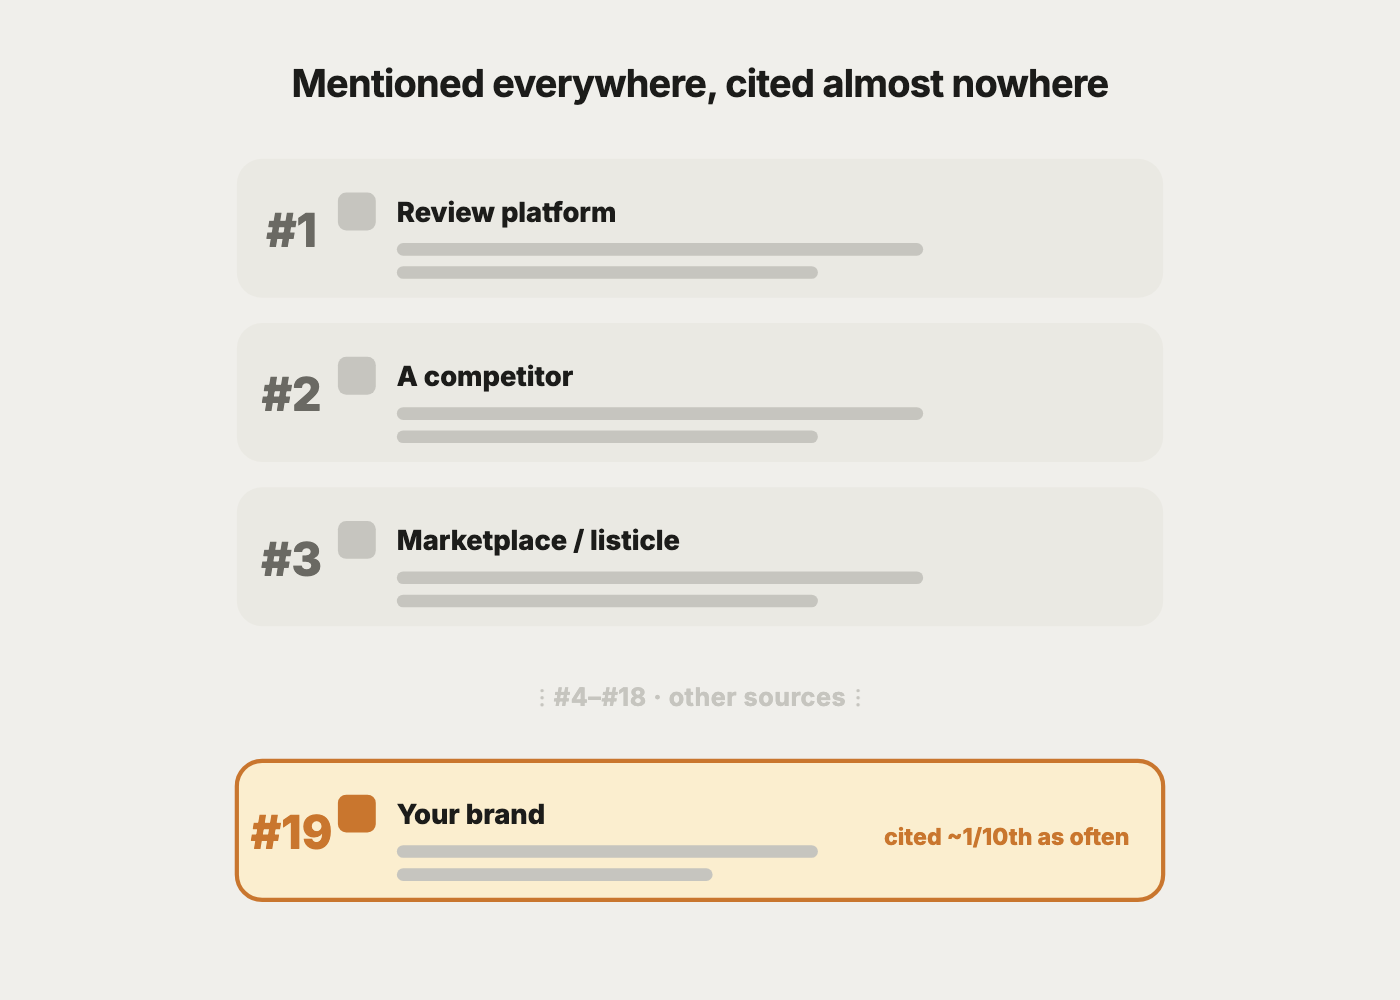 该品牌在 AI 回答真正引用的来源里排在什么位置(标签已匿名,只展示排名)。一个测评平台和一个竞争对手排在最上面;我们的品牌被压在第 19/20 名——被引用的频率大约只有前列的十分之一。
这道差距很关键,因为真正改变模型"怎么谈论你"的,是被引用,而不只是被提及。我们在 500 条真实 AI 回答上做了测量。结果如下。
先说清楚:我们怎么衡量"情感分""可见度"和"提升"
三个朴素的定义,因为后面全靠它们:
- 情感分(sentiment score,0–100): 模型在回答里"谈论"这个品牌时有多正面。
- 可见度(visibility,0–100): 品牌在这条回答里出现得有多显眼、多正面。
- 提升(lift): 两组之间的差值。比如我们说"情感分 +12.7",意思是"被引用组"比"未被引用组"平均高 12.7 分。
做法是这样:我们对同一批对比类 prompt,发散(fan-out)到每个主流回答引擎,收集了 500 条 AI 回答,然后分成两堆:一堆引用了我们客户的页面作为来源(226 条),另一堆没有引用(274 条)——再把两堆放在一起比。同样的 prompt,所以是同口径对比。
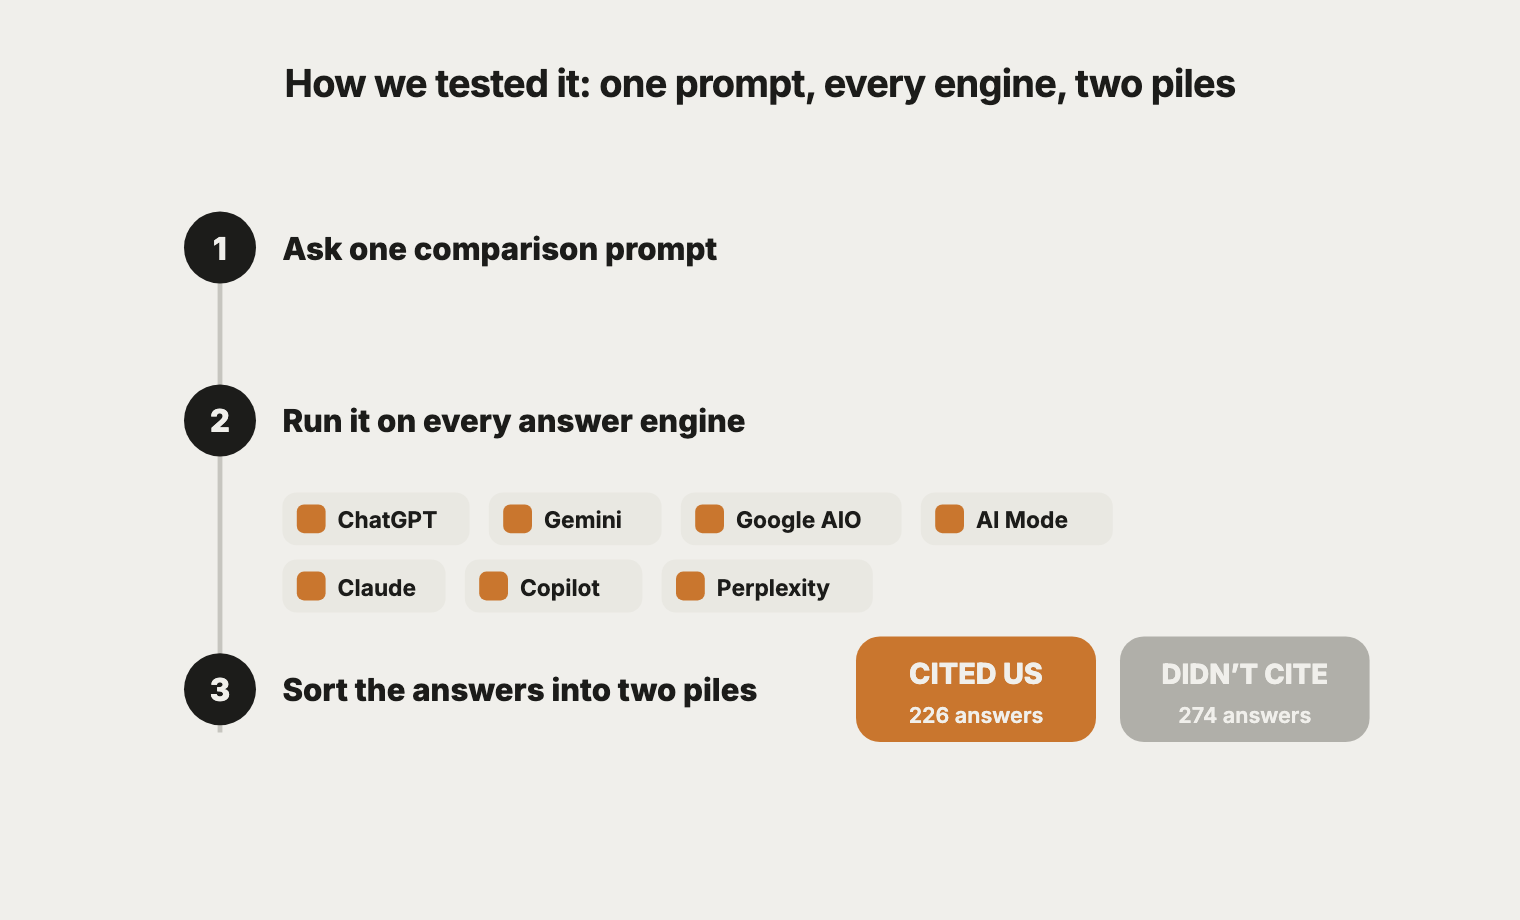 测试三步走:问一条对比类 prompt,在每个回答引擎上都跑一遍(ChatGPT、Gemini、Google AI Overviews、AI Mode、Claude、Copilot、Perplexity),再把 500 条回答分进两堆——引用了我们(226 条)vs 没引用(274 条)。(引擎名以占位形式展示,真实 logo 可后续替换。)
有一点要老实说:这是一次观察性对比,被引用的页面也可能在别的方面本来就更好。但这个规律足够强、足够一致,而且不管因果如何,它指向的打法都是同一套。
被 AI 引用之后,到底有什么变化?
三件事一起往好的方向走。
情感分大约上升 20%。 被引用的回答,情感分平均 76.7,而没被引用时是 64.0——提升了 12.7 分。可见度也几乎同步:88.5 对 74.5,提升 13.9。
举个具体的例子。当品牌没被引用时,回答往往很泛:"这个领域有好几个工具,有些用户觉得 [品牌] 偏贵"——一句从模型记忆里捞出来的、不冷不热的话。而当品牌被引用时,模型会用自己的话复述我们自己的页面,语气就变了:"[品牌] 在配送时间预估准确度和品牌化物流追踪页方面很突出,面向成长型团队的分析能力也很强。"注意,模型并不是逐字照抄我们——它是在转述被引用的来源;但正因为它转述的来源是我们的页面,描述就变得既暖又具体,而不是含糊其辞。你把任何一条"暖"的回答往回追溯,通常都会在它的参考来源里找到我们的某个 URL。
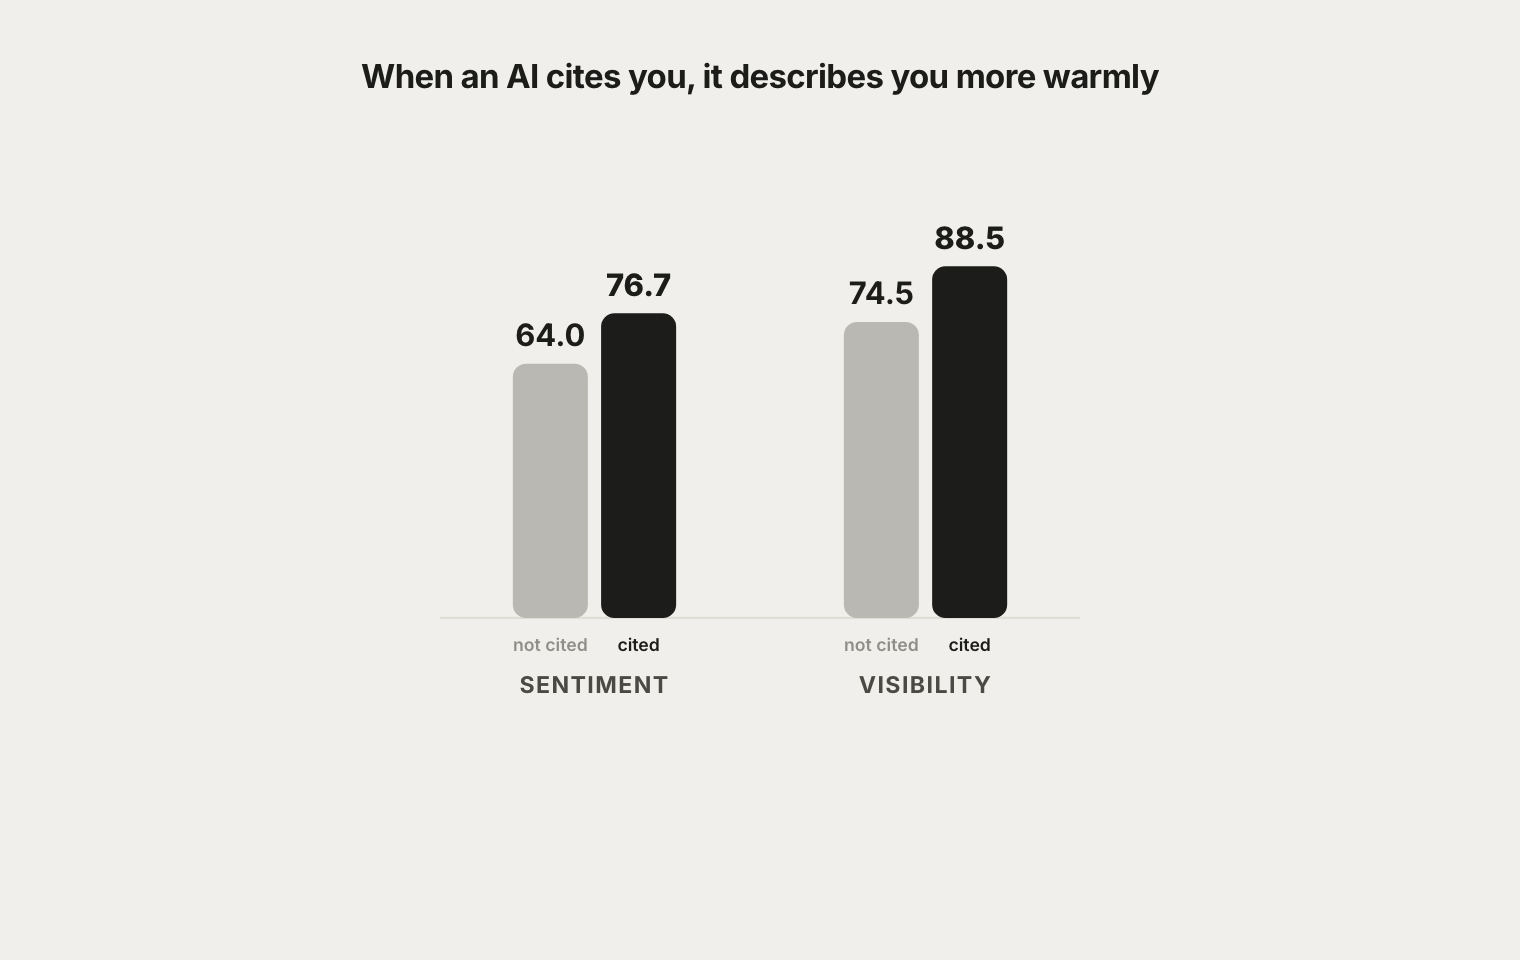 被引用的回答在情感分和可见度上都更高(0–100 分)。浅色柱=没引用我们的回答,深色柱=引用了我们的回答。
而且它会体现在真实的搜索行为上。 点击 AI 引用链接的人很少,所以一个在 AI 回答里看到你的人,通常会做下一件顺理成章的事——去搜你的品牌名。我们就盯着这个看。在落到首页的品牌词查询上,排名位置基本没动(大约 1.6–1.9),但点击率(CTR)从 3.7% 涨到了 4.9%——提升 32.4%。位置不变、点击上升,说明这是 AI 曝光带来的新需求,而不是排名波动的假象。
关键在"被引用几次",还是"有没有被引用"?
答案是:关键是从 0 到 1 的那一下,而不是数量。 只引用了一个 URL 的回答,情感分平均 82.8;引用了两个及以上的,平均只有 71.1(相关系数 −0.36——引用越多,语气反而略微更冷)。所以该做的是赢下一个干净的引用,而不是往回答里堆一堆链接。
这个提升在每个 AI 引擎上都一样吗?
乍一看,不一样——情感分的提升,看起来主要集中在 ChatGPT 这边:+9.8 分(被引用 83.9 对未被引用 74.1),而 Copilot 上几乎没动。但当你去追问为什么,更有用的结论恰恰相反:这个提升在各引擎上很可能是一样的——真正不同的,是每个模型到底能在哪个搜索索引里"找到"你。
机制在这里,也是这篇文章里最重要的一点。不同的助手读取不同的搜索后端:ChatGPT 引用的是被 Bing 收录(indexation)的 URL;Claude 和 Gemini(以及 Google 的全家桶 AI 模型)引用的是被 Google 收录的 URL。 当我们那组对比内容上线时,Bing 几乎全都收录了,但 Google 只收录了大约 30%。所以 ChatGPT 能找到并引用我们的页面,它的情感分就涨了;而 Google 后端的模型大多根本没法引用我们,也就无从"提升"。它看起来像只有 ChatGPT 在推荐我们,实际上是收录覆盖率不够。随着我们 Google 收录率往上走,同样的提升也开始在 Gemini 和 Google 家族的其它产品上出现。
所以结论不是"为 ChatGPT 做优化",而是:在 Bing 和 Google 上都被收录,引用带来的提升自然会在各引擎间普适开来。
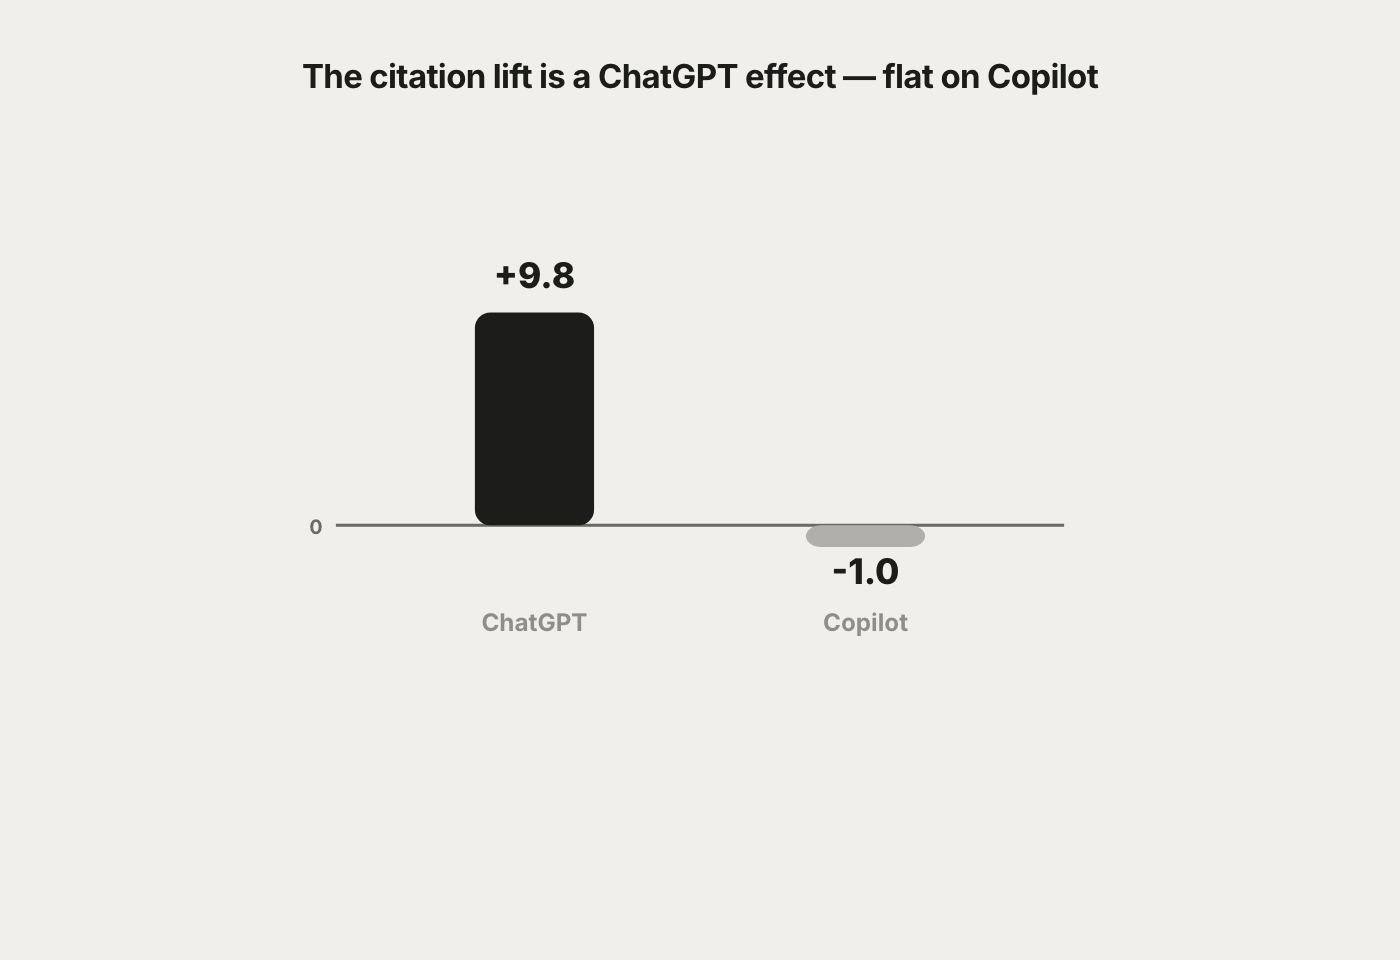 观测到的情感分提升(被引用减去未被引用),单位是分:ChatGPT +9.8,Copilot −1.0。请结合上面的说明来读——它主要反映的是每个引擎当时收录了、能引用哪些页面,而不是引擎本身的"偏好"。
如果你没被引用,风险是什么?
没被引用,绝不只是"语气冷一点"这么简单。有两件实打实会出问题的事。
其一:你会被整条回答直接略过。 没被引用的回答,有 15.7% 的情况完全没提到该品牌;而被引用时只有 4.4%——差 3.6 倍。这也是为什么一旦把这些"被略过"算进来,我们的情感分差距会拉大:不算它们时,提升只有 +4.4;把品牌彻底消失的那些算进来,就是 +12.7。真正的伤害,恰恰在那些你压根不在场的回答里。
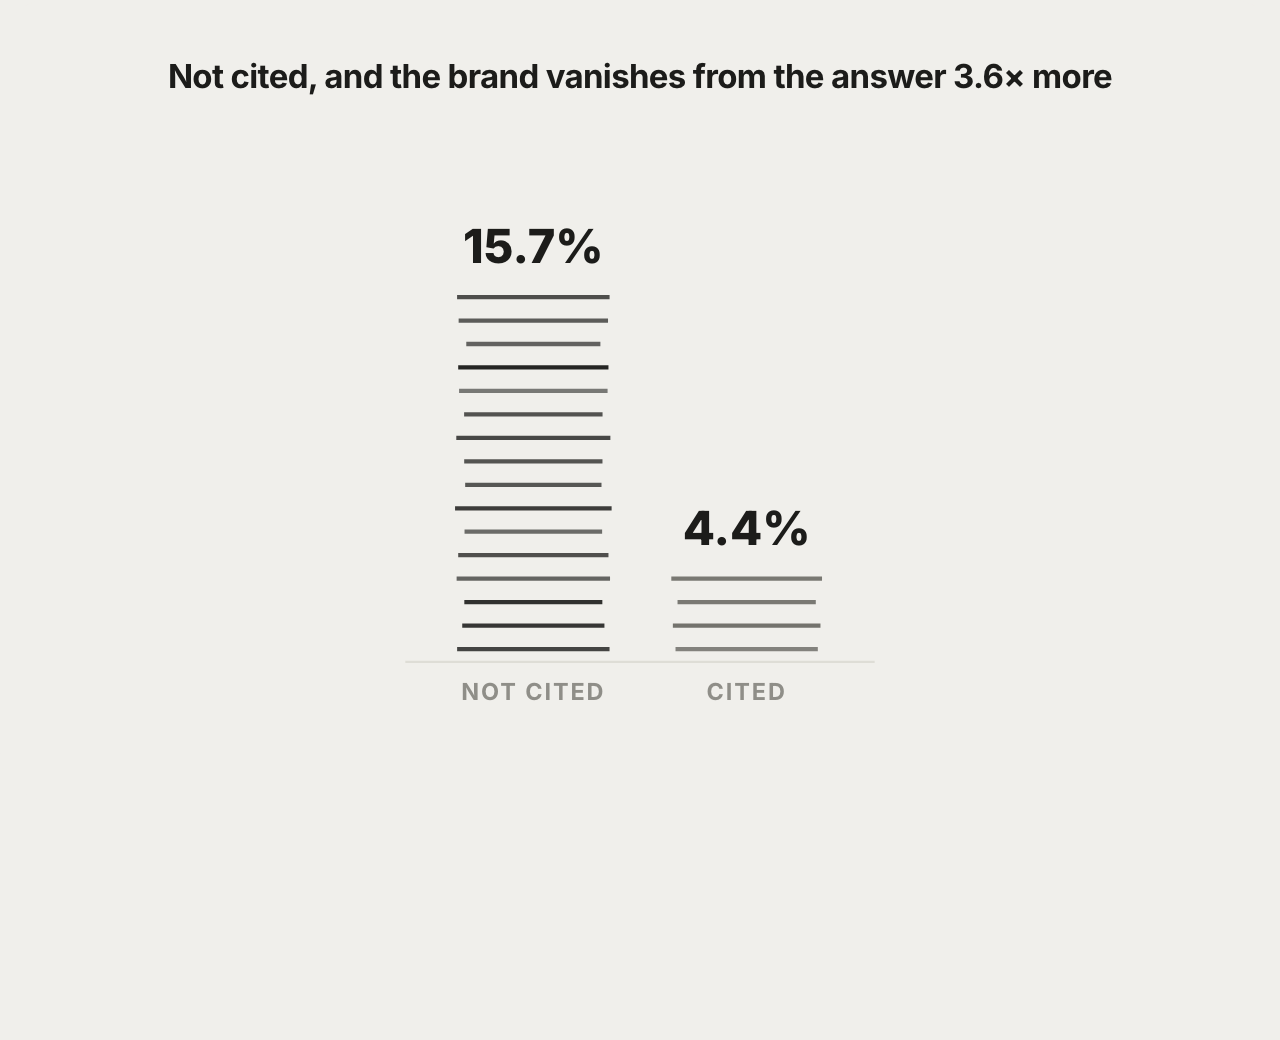 每一格大约代表 1% 的回答彻底没提到该品牌。没被引用的回答,把品牌略过的频率是被引用时的 3.6 倍。
其二:你的故事会被别人的内容替你写。 AI 不会逐字引用你——它会把它拉到的各种来源改写、翻译、再综合成一条回答。如果它取材的来源里,充斥着第三方的抱怨或注水测评,那那些就成了你的叙事——而由于你自己的页面一个都没被引用,你在这条回答里连辩驳的机会都没有。同一个问题,答案是暖是冷,可能纯粹取决于模型当时收录了哪些来源。
那到底怎么才能被引用?
引用是一条链路的最后一公里,链上每一环都是实打实的活儿。它不是一个一按就好的开关。
1. 先被收录——这道硬门槛。 AI 只能引用它的搜索后端真正收录过的页面。在我们分析的一组内容里,Google 只收录了 31% 的页面。这些被收录的页面被引用的比例是 79%,而没被收录的只有 31%。而且各引擎看到的页面不一样:同一组内容,Bing 收录了 92%。所以 ChatGPT 和 Copilot(走 Bing)能引用的页面,Gemini 和 Google AI Overviews(走 Google)根本引用不到。
2. 搭对内容集群(Cluster)。 把内容按真实的买家人群和真实需求——人们真正会问的问题——组织成集群,而不是你想写什么就写什么。
3. 把页面做上排名。 排名是进入实时检索、进而被引用的入场券。停在非品牌词第 15–30 位的页面根本不会被检索到,写得再好也无从被引用。
4. 按每个 AI 的引用偏好来组织内容。 每个引擎奖励的信号不一样。在我们的分析里,加一个 FAQ 区块,让内容被 Claude 引用的可能性提高了 10.75 倍;明确点名具体的产品功能,在 ChatGPT 上拿到了 9.9 倍;地域信息在 Google AI Overviews 上值 13.7 倍,但在另外两个上反而是减分项。
真正的启示是:没有一份能装到每个页面上的万能清单。 什么会被引用,取决于平台、行业、页面类型和主题。唯一可靠的方法是——把每个 AI 现在针对你这个目标 prompt 引用的那些页面拉出来,反推它们的共同点,然后照着补齐。具体定价在我们的数据里恰好对三个引擎都有帮助,但即便是它,也请当成一个需要按主题逐一验证的假设,而不是一条固定规则。
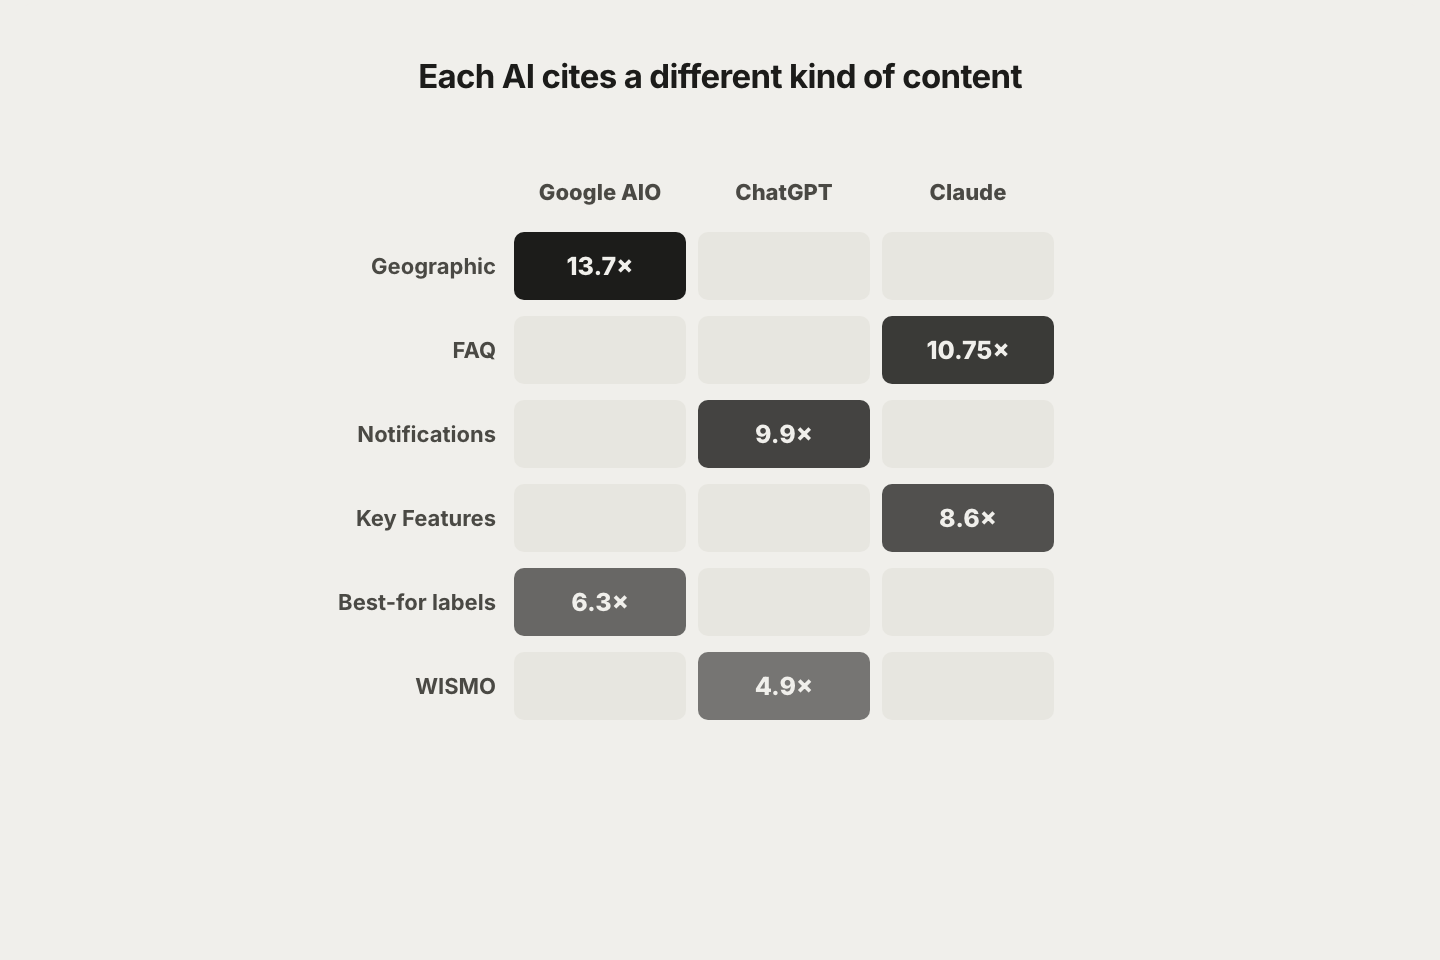 每个 AI 对某类内容信号的引用倾向有多强。颜色越深=拉力越大。不同引擎奖励不同的内容——没有一种格式能在所有引擎上通吃。
5. 然后打磨语气——但别滑向自吹。 一旦被引用,这次提及是"暖"是"冷",取决于被引用的那个页面写了什么。但你不能把一切都改写成给自己贴金:模型对不够中立、自我推销味重的页面很警惕,会悄悄不再引用它们。真正管用的做法,是把"诚实版本"的故事握在自己手里。几个例子:
- 给"批评你的搜索词"也做一个页面。 比如买家在搜"[品牌] 太贵了",就由你来写那个正面回应的页面:先承认这个顾虑,再补上背景(它不适合谁、贵在哪、又值在哪)。当这样一个公道、中立的页面能就这个负面词排到前面,AI 引用的就会是你的说法,而不是竞争对手替你下的结论。
- 按不同人群,写不同的回应。 同一个槽点,对不同买家意味着不同的事。就拿"太贵"来说:面向中小企业(SMB),你就讲入门档、讲多快能见效;面向大企业,你就用每个席位的花费,去对比它帮你省下的那笔问题成本。每一种说法,都配一个中立、能被引用的页面。
- 老实承认取舍。 敢写明"某些场景下对手确实更合适"的页面,读起来更可信,也更容易被一直引用下去;那种号称自己样样都赢的页面,反而会被踢出来源名单。
一句总结:在自己的弱点上,做最有用的那个中立来源,而不是嗓门最大的那个鼓吹者。能一直被引用的,是前者。
一句话收尾
提及是门票,引用才是故事——而只有当你自己的页面出现在模型读取的来源里,这个故事才守得住。先被收录,再赢下引用,然后打磨语气。顺序就是这个顺序。